1. HPA란 무엇인가
지난 [Resource Request/Limit과 QoS Class 글]에서 각 Pod에게 CPU/메모리를 얼마나 줄지 정하는 법을 다뤘다면, 이번엔 그 자원 사용률을 기준으로 Pod 개수 자체를 자동으로 늘리고 줄이는 방법을 다룬다.
HPA(HorizontalPodAutoscaler)는 CPU/메모리 사용률(또는 커스텀 메트릭)을 지속적으로 관찰하다가, 목표치를 초과하면 Pod 개수를 늘리고(Scale Out) 여유가 생기면 다시 줄이는(Scale In) Kubernetes 오브젝트다. "Horizontal(수평)"이라는 이름대로 Pod 하나의 스펙을 키우는 대신(Vertical), Pod 개수를 늘려서 트래픽 증가에 대응한다는 점이 핵심이다.
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: my-app-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: my-app
  minReplicas: 2
  maxReplicas: 10
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 50
이 설정은 "my-app Deployment를 대상으로, CPU 평균 사용률이 50%를 넘으면 최대 10개까지 늘리고, 여유가 있으면 최소 2개까지 줄여라"는 뜻이다.
2. HPA는 어떻게 동작하는가 (제어 루프)
HPA는 한 번 계산하고 끝나는 게 아니라, 정해진 주기(기본 15초)로 계속 상태를 확인하고 조정하는 제어 루프(control loop) 방식으로 동작한다.
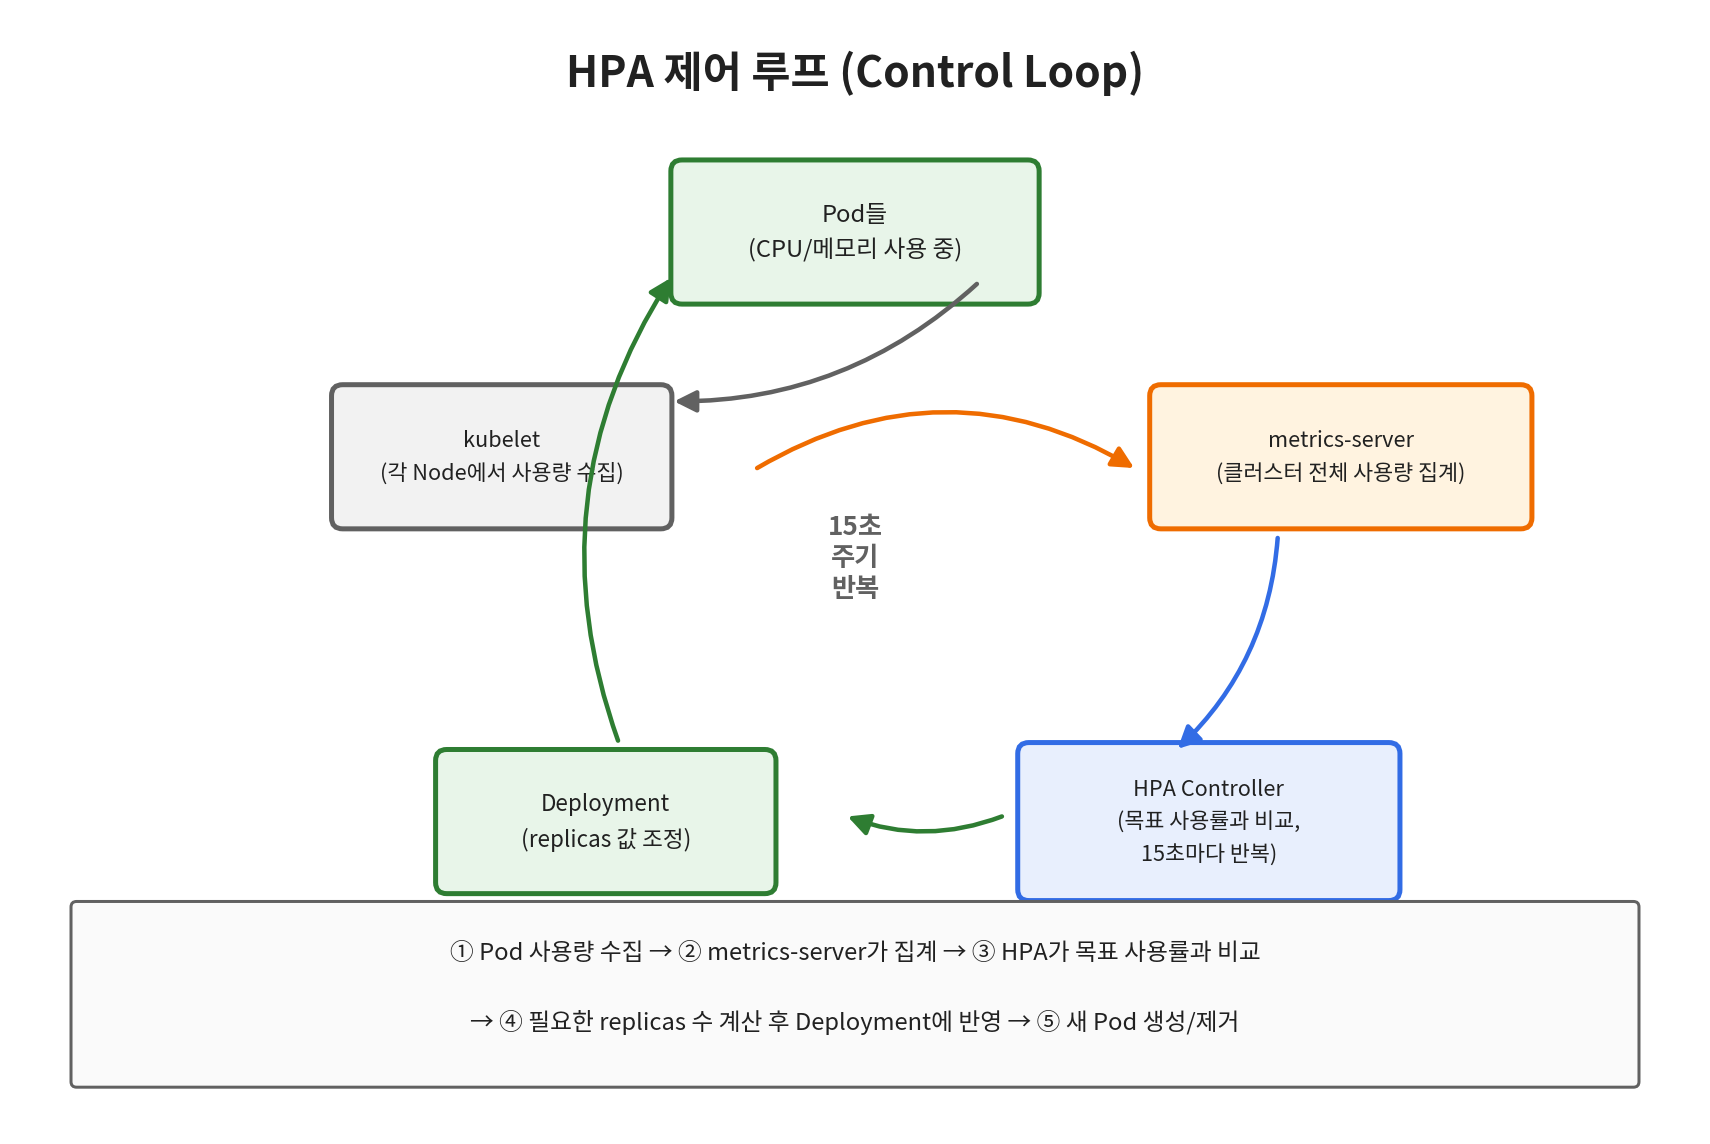
- 각 Node의 kubelet이 자신이 관리하는 Pod들의 CPU/메모리 사용량을 수집한다
- metrics-server가 클러스터 전체의 사용량 데이터를 집계한다
- HPA Controller가 이 데이터를 목표 사용률과 비교한다
- 비교 결과에 따라 필요한 Pod 개수(replicas)를 계산해서 Deployment에 반영한다
- Deployment가 실제로 Pod를 생성하거나 제거한다
이 사이클이 15초마다 반복되며 클러스터 상태를 계속 목표치에 맞춰나간다. 여기서 metrics-server는 필수 전제조건이다. metrics-server가 클러스터에 설치되어 있지 않으면 HPA는 애초에 참고할 사용량 데이터 자체가 없어 동작하지 않는다.
# metrics-server가 설치되어 있는지, 정상 동작하는지 확인
kubectl get deployment metrics-server -n kube-system
kubectl top pods
kubectl top pods가 값을 정상적으로 보여주지 않는다면, HPA를 설정하기 전에 metrics-server 설치/상태부터 확인해야 한다.
3. HPA는 필요한 Pod 개수를 어떻게 계산하는가
HPA의 계산식 자체는 단순하다.

desiredReplicas = ceil( currentReplicas × (currentUsage / targetUsage) )예를 들어 현재 4개의 Pod가 떠 있고, 목표 CPU 사용률이 50%인데 실제 평균 사용률이 80%라면 4 × (80/50) = 6.4를 올림(ceil)해서 7개로 늘어난다.
여기서 반드시 기억해야 할 것은, currentUsage(사용률)의 기준이 Pod의 requests.cpu라는 점이다. 지난 글에서 다룬 것처럼, requests.cpu를 설정하지 않은 Pod는 사용률을 계산할 분모 자체가 없어서 CPU 기반 HPA가 아예 동작하지 않는다. HPA를 쓰려면 대상 Deployment에 requests가 반드시 설정되어 있어야 하고, 이 값을 어떻게 잡느냐에 따라 스케일링이 민감하게 반응하는 정도도 달라진다 (requests를 낮게 잡을수록 사용률 %가 쉽게 튀어서 더 예민하게 반응한다).
4. 스케일 아웃된 새 Pod가 바로 트래픽을 받지 못하는 이유
HPA가 Pod 개수를 늘리기로 결정해도, 그 순간 바로 트래픽 분산 효과가 생기는 것은 아니다. 지난 [Probe 글]에서 다룬 readinessProbe가 여기서 다시 등장한다.
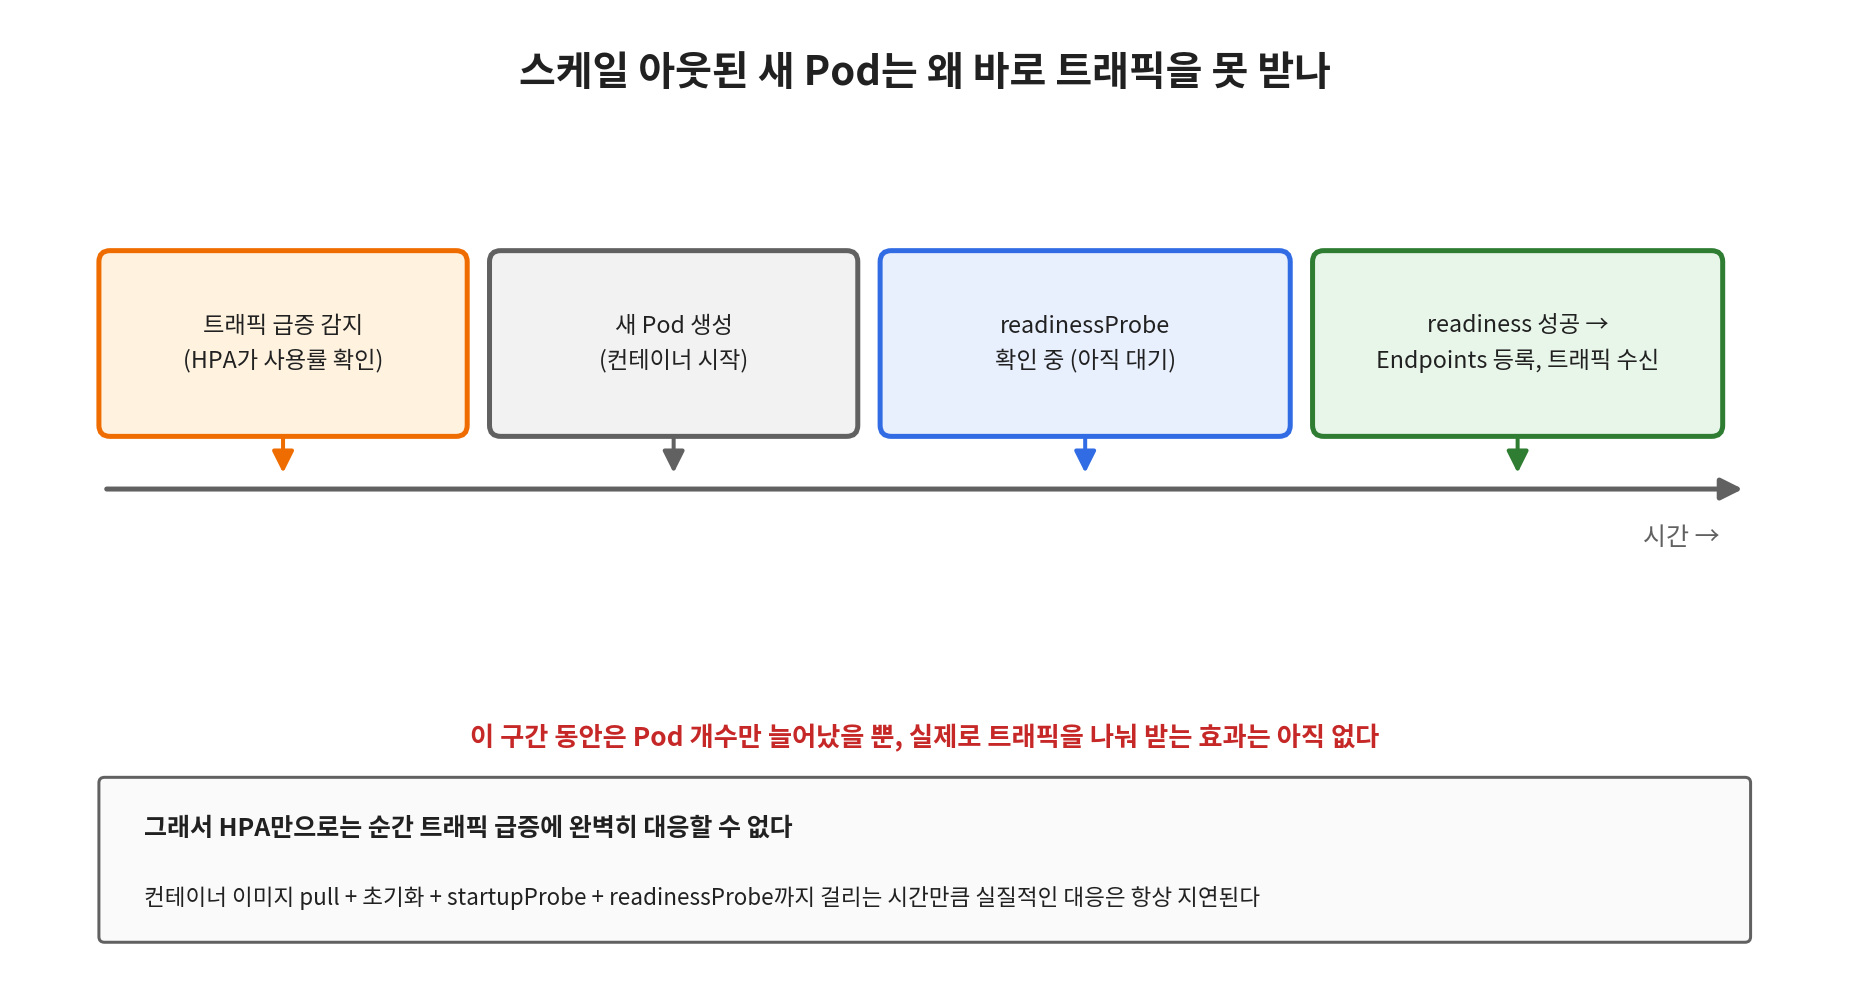
새 Pod가 생성되면 컨테이너 이미지를 받아오고, 애플리케이션이 초기화되고, (설정되어 있다면) startupProbe를 통과하고, readinessProbe가 성공해야 비로소 Service의 Endpoints에 등록되어 실제 트래픽을 나눠 받기 시작한다. 이 전체 과정에 걸리는 시간 동안은 Pod 개수만 늘어났을 뿐 실질적인 트래픽 분산 효과는 없다.
이 때문에 HPA는 이미 진행 중인 트래픽 급증을 완화하는 데는 유용하지만, 아주 짧고 급격한 스파이크(예: 몇 초 만에 트래픽이 수 배로 튀는 경우)에는 대응 속도가 따라가지 못할 수 있다. 이런 경우를 대비하려면 애초에 minReplicas를 여유 있게 잡아두거나, 예측 가능한 트래픽 패턴(정기 이벤트 등)에는 사전에 수동으로 replicas를 늘려두는 것도 함께 고려해야 한다.
5. Scale Down은 왜 더 신중하게 움직이는가
HPA는 Scale Out(늘리기)보다 Scale In(줄이기)에서 훨씬 보수적으로 동작하도록 기본 설계되어 있다. 사용률이 순간적으로 떨어졌다고 바로 Pod를 줄여버리면, 트래픽이 다시 튀는 순간 방금 설명한 "새 Pod가 준비되는 데 걸리는 시간" 지연이 반복적으로 발생하며 오히려 불안정해지기 때문이다.
이를 제어하는 것이 안정화 기간(stabilization window)이다.
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: my-app-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: my-app
  minReplicas: 2
  maxReplicas: 10
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 50
  behavior:
    scaleDown:
      stabilizationWindowSeconds: 300   # 최근 5분간의 추천치 중 가장 큰 값을 사용
      policies:
        - type: Pods
          value: 1
          periodSeconds: 60             # 한 번에 최대 1개씩만, 60초 간격으로 축소
    scaleUp:
      stabilizationWindowSeconds: 0     # Scale Out은 즉시 반영
      policies:
        - type: Percent
          value: 100
          periodSeconds: 30             # 30초마다 최대 100%까지 증가 허용
scaleDown.stabilizationWindowSeconds: 300은 "최근 5분간 계산된 추천 replicas 값들 중 가장 큰 값을 채택하라"는 뜻이다. 즉 5분 사이에 사용률이 잠깐 떨어졌다가 금방 다시 올라오는 패턴이라면, 실제로는 Pod가 줄어들지 않는다. 이렇게 스케일 다운을 의도적으로 느리게 만들어 불필요하게 Pod 개수가 오르락내리락하는 현상(flapping)을 방지한다.
6. CPU/메모리를 넘어선 커스텀 메트릭
HPA는 CPU/메모리 같은 기본 리소스 메트릭뿐 아니라, 애플리케이션이 직접 노출하는 커스텀 메트릭(예: 초당 요청 수, 큐에 쌓인 메시지 수)을 기준으로도 스케일링할 수 있다. 이 경우 Prometheus Adapter 같은 별도의 메트릭 어댑터가 필요하다.
metrics:
  - type: Pods
    pods:
      metric:
        name: http_requests_per_second
      target:
        type: AverageValue
        averageValue: "100"
이 설정은 "Pod 하나당 평균 초당 요청 수가 100을 넘으면 늘려라"는 의미다. CPU 사용률이 실제 부하와 정비례하지 않는 애플리케이션(I/O 대기가 많은 경우 등)이라면, CPU 기반보다 이런 비즈니스 메트릭 기반 스케일링이 훨씬 정확할 수 있다.
7. 정리
| 개념 | 내용 |
|---|---|
| HPA의 역할 | 사용률 기준으로 Pod 개수(replicas)를 자동으로 조정 |
| 전제조건 | metrics-server 설치 + 대상 Deployment에 requests 설정 필수 |
| 계산 기준 | requests.cpu 대비 실제 사용률(%) |
| Scale Out 한계 | 새 Pod가 readinessProbe를 통과할 때까지는 실질적 효과 없음 |
| Scale Down 특징 | stabilizationWindowSeconds로 의도적으로 느리게 동작 (flapping 방지) |
| 확장 | CPU/메모리 외 커스텀 메트릭(RPS, 큐 길이 등) 기반 스케일링 가능 |
HPA는 앞서 다룬 requests/limits, readinessProbe 설정이 제대로 되어 있어야 비로소 제대로 동작하는 기능이다. 이 둘이 빠진 상태에서 HPA만 설정하면 "Pod 개수는 늘어나는데 왜 트래픽이 안 분산되지?"와 같은 혼란스러운 상황을 겪기 쉽다. HPA를 도입하기 전에 먼저 requests가 현실적인 값으로 설정되어 있는지, readinessProbe가 제대로 구성되어 있는지부터 점검하는 것이 순서다.
'프로그래밍 > k8s' 카테고리의 다른 글
| Kubernetes 롤링 업데이트 & 롤백 완벽 정리 (0) | 2026.09.17 |
|---|---|
| Kubernetes Resource Request/Limit과 QoS Class 완벽 정리 (0) | 2026.09.14 |
| Kubernetes Probe 완벽 정리 — livenessProbe / readinessProbe / startupProbe (0) | 2026.09.11 |
| Kubernetes YAML 설정 파일 완벽 정리 — 구조와 주요 리소스 예제 (0) | 2026.09.10 |
| Kubernetes RWX(ReadWriteMany) 완벽 정리 — 개념부터 실전 예제까지 (0) | 2026.09.09 |