1. requests와 limits, 왜 둘 다 필요한가
지난 Probe 글에서 "Pod의 상태를 어떻게 판단할지"를 다뤘다면, 이번엔 그 Pod에게 자원을 얼마나 줄지를 다룬다. Kubernetes에서 컨테이너의 CPU/메모리 사용량을 제어하는 필드는 requests와 limits 두 가지이고, 이 둘은 이름은 비슷해 보여도 동작하는 시점과 목적이 완전히 다르다.
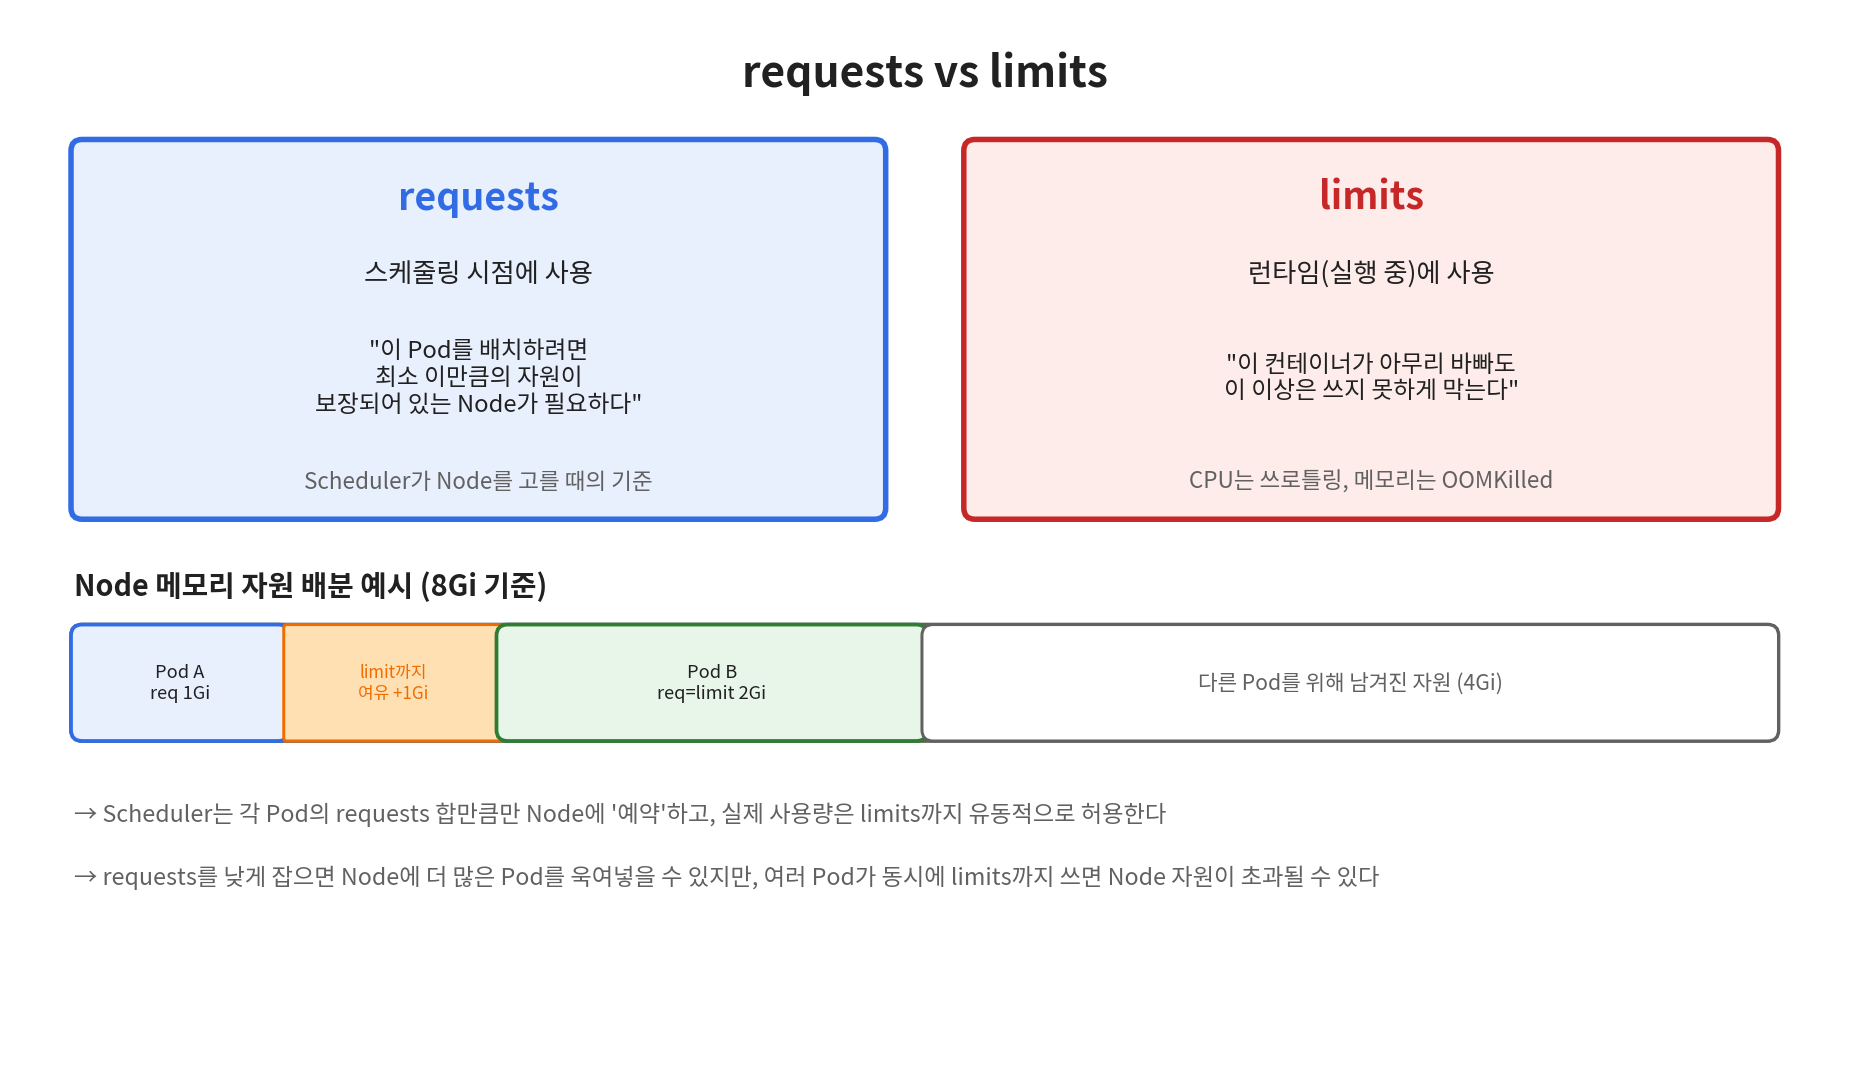
- requests: 스케줄링 시점에 사용된다. "이 Pod를 배치하려면 최소 이만큼의 자원이 보장된 Node가 필요하다"는 선언이며, Scheduler는 각 Node의 여유 자원과 이 값을 비교해서 Pod를 어디에 배치할지 결정한다
- limits: 런타임(실행 중)에 사용된다. "이 컨테이너가 아무리 바빠도 이 이상은 쓰지 못하게 막는다"는 상한선이며, 이를 넘어서면 CPU는 쓰로틀링되고 메모리는 컨테이너가 강제 종료(OOMKilled)된다
resources:
  requests:
    cpu: "250m"        # 0.25 코어
    memory: "256Mi"
  limits:
    cpu: "500m"         # 0.5 코어
memory: "512Mi"requests를 낮게 잡으면 Node 하나에 더 많은 Pod를 배치할 수 있지만, 여러 Pod가 동시에 limits까지 자원을 쓰면 Node 전체 자원이 실제로는 부족해질 수 있다. 이 간극을 이해하고 적절히 관리하는 것이 리소스 설정의 핵심이다.
2. requests/limits를 설정하지 않으면 생기는 문제
"일단 설정 없이 배포하고 보자"는 실무에서 흔히 벌어지는 선택이지만, 이는 다음과 같은 구체적인 문제로 이어진다.
- Node 자원을 예측할 수 없다: requests가 없으면 Scheduler는 그 Pod가 얼마나 자원을 쓸지 전혀 모른 채로 배치한다. 결과적으로 한 Node에 자원을 많이 쓰는 Pod들이 우연히 몰리면, Node 전체가 자원 부족 상태에 빠질 수 있다
- 소수의 Pod가 Node 자원을 독점할 수 있다: limits가 없으면 특정 컨테이너가 메모리 누수(memory leak)나 트래픽 급증으로 계속 자원을 늘려 써도 막을 방법이 없고, 결국 같은 Node의 다른 Pod들까지 자원 부족의 영향을 받는다
- 장애 시 가장 먼저 희생된다: 뒤에서 설명할 QoS Class 체계상, requests/limits를 아예 설정하지 않은 Pod는 자동으로 가장 낮은 우선순위(BestEffort)가 되어 Node 자원이 부족할 때 가장 먼저 축출(eviction) 대상이 된다
3. QoS Class — Kubernetes가 Pod의 "등급"을 매기는 방법
Kubernetes는 각 Pod의 requests/limits 설정 조합을 보고 자동으로 3가지 QoS(Quality of Service) Class 중 하나를 부여한다. 이 등급은 Node의 자원이 부족해졌을 때 어떤 Pod부터 희생시킬지를 결정하는 기준이 된다.

3.1 Guaranteed
Pod 안의 모든 컨테이너가 CPU와 메모리 모두 requests == limits로 설정되어 있을 때 부여된다. 이 Pod는 정확히 요청한 만큼의 자원이 항상 보장되며, Node 자원이 부족해도 가장 나중까지 살아남는다.
resources:
  requests:
    cpu: "500m"
    memory: "512Mi"
  limits:
    cpu: "500m"
    memory: "512Mi"
3.2 Burstable
requests는 설정했지만 limits가 더 크거나(또는 일부만 설정되어) requests와 limits가 정확히 일치하지 않는 경우다. 평소에는 requests만큼만 쓰다가, 필요할 때 limits까지 자원을 "순간적으로 더 쓸 수(burst)" 있다는 뜻에서 이런 이름이 붙었다. 대부분의 일반적인 애플리케이션이 이 등급에 해당한다.
3.3 BestEffort
requests와 limits를 둘 다 설정하지 않은 경우 자동으로 부여된다. 이 Pod는 자원을 얼마나 쓸지 아무 보장도, 제한도 없다는 뜻이고, Node 자원이 부족해지면 가장 먼저 축출 대상이 된다.
3.4 확인 방법
이미 떠 있는 Pod의 QoS Class는 아래 명령으로 바로 확인할 수 있다.
kubectl get pod my-app-abc123 -o jsonpath='{.status.qosClass}'4. OOMKilled는 왜, 언제 발생하는가
메모리 관련 장애 중 가장 흔하게 마주치는 것이 OOMKilled다. 이게 정확히 어떤 상황에서 벌어지는지 이해하면 원인 파악이 훨씬 쉬워진다.
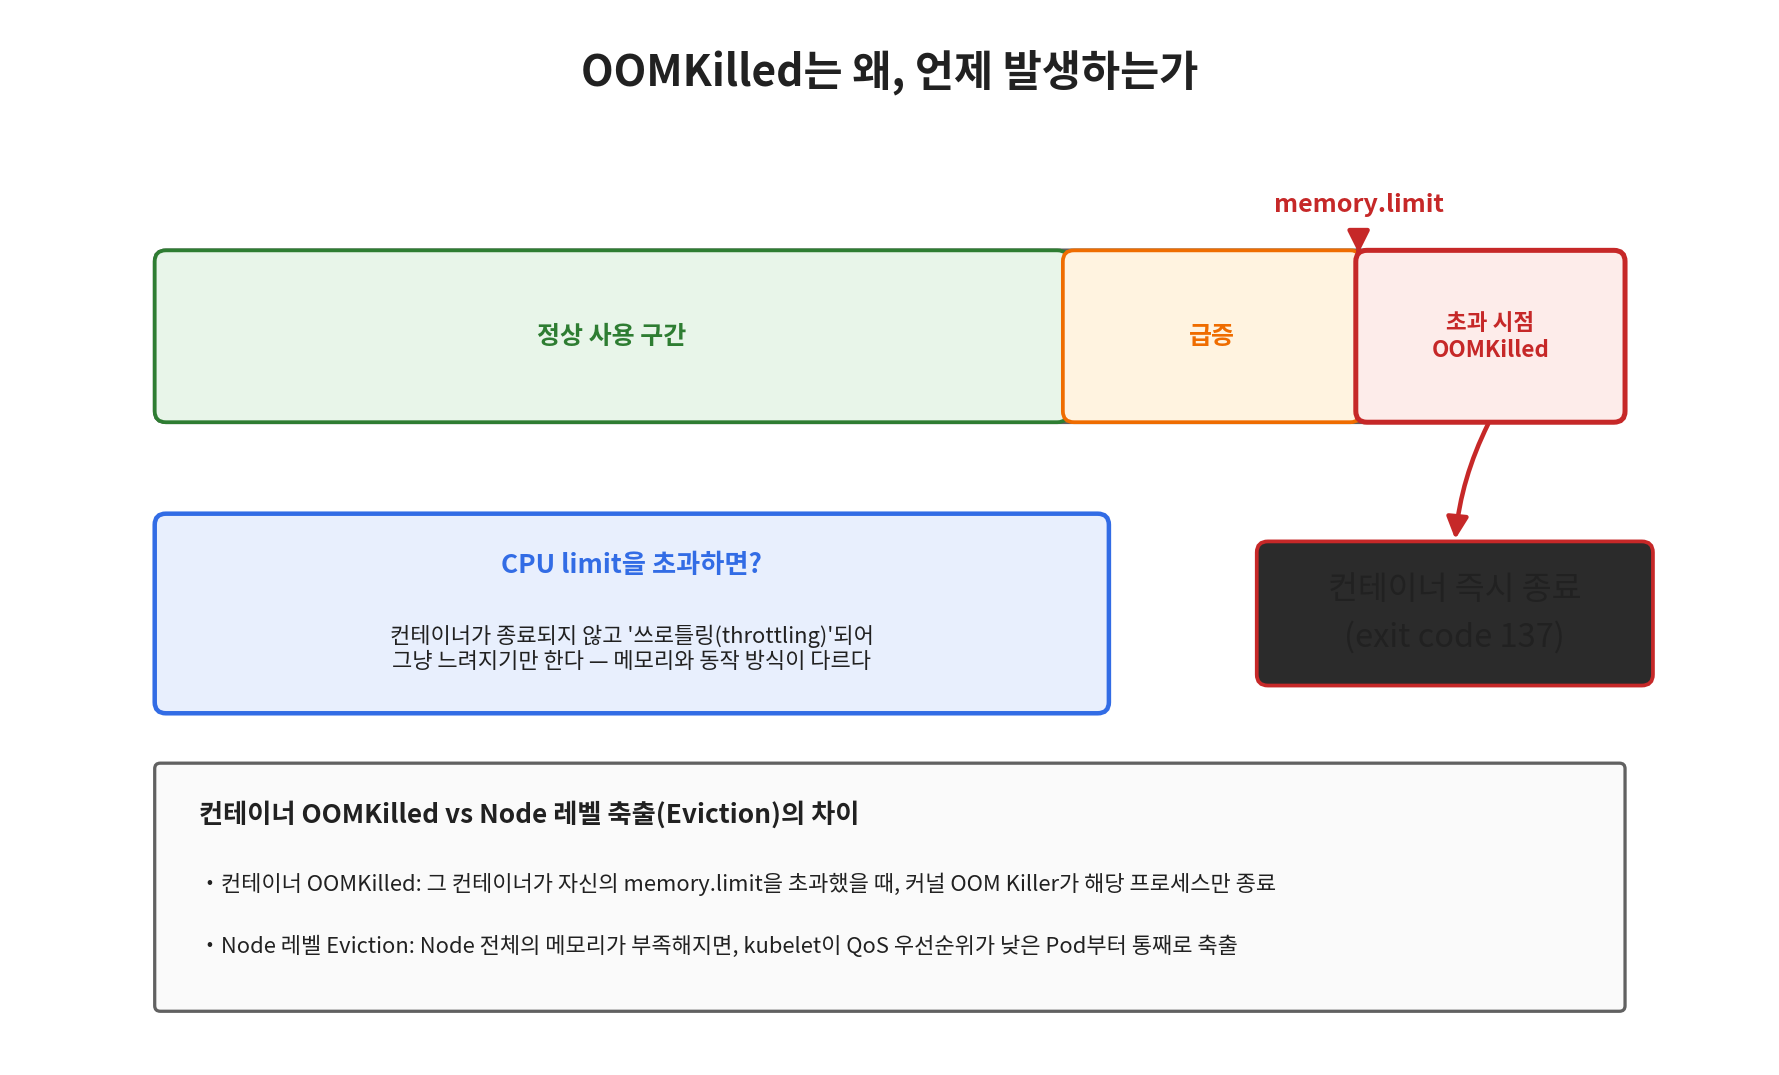
컨테이너의 메모리 사용량이 limits.memory를 초과하는 순간, Linux 커널의 OOM(Out Of Memory) Killer가 개입해서 해당 프로세스를 즉시 강제 종료시킨다. 이때 종료 코드는 137(128 + SIGKILL의 시그널 번호 9)로 나타나며, kubectl describe pod로 확인하면 Last State에 OOMKilled라고 표시된다.
kubectl describe pod my-app-abc123
# ...
# Last State:     Terminated
#   Reason:       OOMKilled
#   Exit Code:    137
중요한 점은 CPU limit 초과와 메모리 limit 초과의 동작 방식이 다르다는 것이다. CPU는 limits.cpu를 넘겨도 컨테이너가 종료되지 않고, 그냥 그 이상 CPU를 배정받지 못해 느려지는 쓰로틀링(throttling)만 발생한다. 반면 메모리는 초과 즉시 프로세스가 강제 종료된다. 이 차이 때문에 메모리 limit은 CPU limit보다 훨씬 신중하게 설정해야 한다 — 너무 타이트하게 잡으면 정상적인 트래픽 증가만으로도 계속 재시작되는 상황이 벌어질 수 있다.
4.1 컨테이너 OOMKilled vs Node 레벨 Eviction
비슷해 보이지만 다른 두 가지 상황을 구분해야 한다.
- 컨테이너 OOMKilled: 그 컨테이너 자신이 자신의
limits.memory를 초과했을 때, 커널이 그 프로세스만 종료한다 - Node 레벨 Eviction: Node 전체의 메모리가 부족해지면(다른 Pod들 때문일 수도 있다), kubelet이 QoS 우선순위가 낮은 Pod부터 통째로 축출한다. 이 경우 해당 Pod 입장에서는 자신이 limits를 넘기지 않았는데도 쫓겨날 수 있다
5. 실전 설정 가이드
5.1 값을 어떻게 잡을 것인가
정답은 없지만, 일반적으로 아래 순서를 따른다.
- 개발/스테이징 환경 또는 모니터링 도구(Prometheus 등)로 애플리케이션의 평소 CPU/메모리 사용량을 측정한다
- requests는 평소 사용량 수준으로 설정한다 (Scheduler가 현실적인 배치를 하도록)
- limits는 평소 사용량보다 여유를 두되, 무한정 크게 잡지 않는다 (한 Pod가 Node를 독점하지 않도록)
- 배포 후 실제
kubectl top pod로 사용량을 관찰하며 값을 조정한다
kubectl top pod my-app-abc1235.2 CPU와 메모리 단위
| 단위 | 의미 |
|---|---|
cpu: "500m" |
0.5 코어 (m은 밀리코어, 1000m = 1 코어) |
cpu: "1" |
1 코어 전체 |
memory: "512Mi" |
512 메비바이트 (2진수 기준, 1Mi = 1024Ki) |
memory: "512M" |
512 메가바이트 (10진수 기준, 1M = 1000K) |
Mi와 M을 혼동하지 않도록 주의해야 한다. 대부분의 예제와 실무에서는 Mi, Gi(2진수 기준)를 사용한다.
5.3 네임스페이스 단위로 기본값/상한 강제하기
개별 Pod마다 설정을 깜빡하는 것을 막고 싶다면, 네임스페이스 레벨에서 기본값과 상한을 강제할 수 있다.
# LimitRange: requests/limits를 설정하지 않은 Pod에 기본값 자동 적용
apiVersion: v1
kind: LimitRange
metadata:
  name: default-limits
spec:
  limits:
    - default:
        cpu: "500m"
        memory: "512Mi"
      defaultRequest:
        cpu: "250m"
        memory: "256Mi"
      type: Container
---
# ResourceQuota: 네임스페이스 전체가 쓸 수 있는 자원 총량 제한
apiVersion: v1
kind: ResourceQuota
metadata:
  name: namespace-quota
spec:
  hard:
    requests.cpu: "10"
    requests.memory: 20Gi
    limits.cpu: "20"
limits.memory: 40GiLimitRange는 개별 Pod가 값을 빠뜨렸을 때의 안전망 역할을, ResourceQuota는 팀/네임스페이스 전체가 클러스터 자원을 과도하게 점유하지 못하도록 막는 역할을 한다. 여러 팀이 하나의 클러스터를 공유하는 환경이라면 이 둘을 함께 쓰는 것이 사실상 필수다.
6. 정리
| 필드 | 사용 시점 | 초과 시 동작 |
|---|---|---|
| requests | 스케줄링 (Pod를 어디에 배치할지) | 해당 없음 (배치 기준일 뿐) |
| limits | 런타임 (실행 중 자원 제한) | CPU: 쓰로틀링 / 메모리: OOMKilled |
| QoS Class | 조건 | Node 자원 부족 시 |
|---|---|---|
| Guaranteed | 모든 컨테이너의 requests == limits | 가장 나중에 축출 |
| Burstable | requests < limits (일부 설정) | 두 번째로 축출 |
| BestEffort | requests/limits 모두 미설정 | 가장 먼저 축출 |
Probe가 "이 Pod가 정상인지"를 판단하는 기준이라면, requests/limits는 "이 Pod에게 얼마나 자원을 줄지"를 정하는 기준이다. 둘 다 설정하지 않아도 당장 애플리케이션은 잘 뜨기 때문에 후순위로 밀리기 쉽지만, 실제 장애 상황(OOMKilled, Node 자원 부족으로 인한 연쇄 축출)의 상당수는 이 설정의 부재에서 시작된다. Probe와 마찬가지로, 매니페스트를 처음 작성하는 시점부터 최소한의 requests/limits는 기본값으로 넣어두는 습관을 들이는 것이 좋다.
'프로그래밍 > k8s' 카테고리의 다른 글
| Kubernetes 롤링 업데이트 & 롤백 완벽 정리 (0) | 2026.09.17 |
|---|---|
| Kubernetes HPA(HorizontalPodAutoscaler) 완벽 정리 (0) | 2026.09.16 |
| Kubernetes Probe 완벽 정리 — livenessProbe / readinessProbe / startupProbe (0) | 2026.09.11 |
| Kubernetes YAML 설정 파일 완벽 정리 — 구조와 주요 리소스 예제 (0) | 2026.09.10 |
| Kubernetes RWX(ReadWriteMany) 완벽 정리 — 개념부터 실전 예제까지 (0) | 2026.09.09 |